Введение
За многолетнюю практику работы на финансовых рынках мне довелось иметь дело с самыми разными участниками и консультантами. У каждого традиционного источника аналитики и торговых идей были характерные признаки, позволявшие оценить степень его субъективности: излишняя эмоциональность брокера, предлагающего «идею», подчёркнутая уверенность банковского аналитика накануне разворота тренда, спекулятивный азарт непрофессиональных участников. Опытный инвестор со временем учится распознавать эти признаки почти безошибочно.
Модели ИИ демонстрируют принципиально иной профиль поведения. Они работают круглосуточно, не подвержены эмоциональным колебаниям, сохраняют неизменно корректный тон и отвечают на любой запрос за секунды. Мошенника обычно выдаёт блеск в глазах; у языковой модели глаз нет. Для начинающего инвестора такой собеседник создаёт иллюзию абсолютной компетентности и скрывает фундаментальные технологические изъяны.
Настоящий анализ опирается на практический опыт нашей команды в American Investor, где аналитические отчёты о рынке готовит гибридный конвейер «человек и ИИ». Мое инженерное образование в этом контексте лишь обостряло проблему: в традиционной инженерии прибор, выдающий разные показания при одинаковых входных параметрах, признаётся неисправным и подлежит замене, тогда как в сфере ИИ подобные системы массово применяются для принятия финансовых решений.
1. Рынок как адаптивная система
Начать следует с рынка, поскольку именно его устройство определяет цену любой ошибки. Рынок принципиально отличается от детерминированных физических систем. Ракетный двигатель подчиняется уравнениям: при заданном давлении в камере он развивает расчётную тягу сегодня, завтра и через год. Финансовый рынок представляет собой совокупность миллионов участников с разными целями, горизонтами инвестирования и объёмом капитала, и каждый из них ориентируется не столько на фундаментальную стоимость актива, сколько на ожидания остальных. Рыночная цена — это не результат расчёта, а итог непрерывного взаимного оценивания намерений, в котором само оценивание меняет результат. В итоге мы столкнулись с несколькими видами системных ограничений и специфичных для ИИ рисков.
Обратные связи и эволюция стратегий
Ключевую роль в рыночной динамике играют механизмы обратной связи:
• Положительная обратная связь усиливает движение: рост цены привлекает покупателей, покупки толкают цену выше, что привлекает новых покупателей.
• Отрицательная обратная связь гасит движение: переоценённый актив продают, продажи снижают цену, и она возвращается к разумному уровню.
В разные периоды рынком управляют разные связи, и ни одна модель не позволяет заранее определить, какая из них возьмёт верх. Брайан Артур с коллегами из Института Санта-Фе (Santa Fe Institute) ещё в конце 1980-х построил искусственный рынок, на котором торговали программы-агенты с разными стратегиями, и показал, что набор стратегий непрерывно эволюционирует и ни одна из них не сохраняет устойчивого преимущества на длительном горизонте (Arthur, «Foundations of complexity economics», Nature Reviews Physics, 2021). С тех пор этот вывод подтверждался на реальных рынках столько раз, что превратился в общее место, которое тем не менее каждый новичок открывает для себя лично и за собственный счёт.
Скорость адаптации и затухание закономерностей
Академические исследования подтверждают и быстрый износ публичных торговых закономерностей. Дэвид Маклин и Джеффри Понтифф проверили 97 закономерностей доходности акций, описанных в научных журналах, и установили, что после публикации доходность соответствующих стратегий снижается в среднем на 58 %. Примерно треть этого снижения объясняется тем, что участники рынка прочитали публикацию и использовали закономерность до её исчезновения (McLean, Pontiff, Journal of Finance, 2016). Языковые модели обучаются на массивах опубликованных текстов, где описаны именно эти закономерности, и неизбежно воспроизводят их в качестве действующих рекомендаций, хотя рынок к моменту ответа уже успел их «отработать».
Однородность решений и системный риск
Синхронизация действий участников способна провоцировать мгновенные кризисы ликвидности. Показательный пример — события 5 февраля 2018 года (Volmageddon): индекс S&P 500 снизился на 4 %, а индекс волатильности VIX вырос на 20 пунктов. По разбору Банка международных расчётов (BIS), биржевые продукты, годами зарабатывавшие на спокойном рынке, были обязаны к концу дня выкупать фьючерсы на волатильность; другие участники заранее подняли цены, и чем выше становилась цена, тем больше фьючерсов продуктам приходилось покупать (BIS Quarterly Review, март 2018). Продукт XIV потерял 84 % стоимости за день и был закрыт. Его держатели не ошиблись в арифметике — они ошиблись, приняв толпу за уравнение.
Массовое внедрение одних и тех же моделей ИИ среди частных инвесторов создаёт аналогичный риск синхронизации решений. На него прямо указывает Международный валютный фонд в Докладе о глобальной финансовой стабильности, предупреждая о стадном поведении и росте волатильности при широком применении ИИ на рынках капитала (IMF Global Financial Stability Report, октябрь 2024, глава 3).
Таким образом, рынок быстро обесценивает общеизвестные закономерности и жёстко наказывает одинаковые решения; ошибка на нём стоит дорого и обнаруживается, как правило, с опозданием.
2. Технологические риски языковых моделей
На таком рынке инструмент анализа должен быть по меньшей мере воспроизводимым и точным. Языковые модели не гарантируют ни того, ни другого, и обе слабости измерены количественно.
| Вариативность (недетерминированность) | Галлюцинации (фактические ошибки) |
|---|---|
| До 76 % задач без единой пары совпавших ответов | До 81 % ошибок или отказов на вопросах по финансовой отчётности |
| Разница в точности до 76 процентных пунктов от одного лишь оформления запроса | Рост галлюцинаций после специализированного дообучения (fine-tuning) |
Вариативность (недетерминированность)
Языковая модель не извлекает ответ из справочника, а последовательно подбирает следующий фрагмент текста (токен) по вероятности. Там, где два варианта почти равновероятны, выбор может пойти в любую сторону, и весь последующий текст строится уже на другом основании. Гарантированной повторяемости результата такая схема не обеспечивает.
• Исследование Университетского колледжа Лондона. Группа Марка Хармана (University College London) задавала ChatGPT одну и ту же задачу по пять раз. На трёх наборах задач доля случаев, когда ни одна пара ответов не совпала по результату, составила 76 %, 51 % и 48 % при стандартных настройках (Ouyang, Zhang, Harman, Wang, FSE 2025). Перевод модели в «строгий» режим с нулевой температурой (temperature = 0) уменьшает разброс, но не устраняет его: это подтвердила отдельная работа, проверившая пять моделей на восьми задачах по десять прогонов каждая (Atil et al., arXiv 2408.04667, 2024).
• Чувствительность к формулировке (prompt sensitivity). Мелани Склар и соавторы показали, что изменение порядка слов, разделителей или пробелов при неизменном смысле задачи меняет точность ответов открытых моделей на величину до 76 процентных пунктов, а у GPT-3.5 — до 56 (Sclar et al., ICLR 2024).
Для инвестора это означает следующее: ответ «да» на вопрос, стоит ли покупать акции компании, — не вывод, а одна из возможных реализаций. Повторный запрос с тем же текстом вполне может принести «нет», изложенное с не меньшей убедительностью.
Фактические ошибки (галлюцинации) в финансовом контексте
Модель обязана выдать связный текст и выдаёт его даже там, где знания отсутствуют. Результат получается грамматически и логически безупречным — и неверным. При работе с точными цифрами это создаёт особенно высокий риск.
• Тест FinanceBench. На простых вопросах по публичной отчётности компаний — таких, на которые младший аналитик отвечает за несколько минут с документом в руках, — модель GPT-4 Turbo с поиском по документам (retrieval-augmented generation, RAG) ответила неверно или отказалась отвечать в 81 % случаев. Без доступа к документам её точность составила 11 % (Islam et al., arXiv 2311.11944, 2023).
• Специализированное дообучение. Исследователи из Колумбийского университета зафиксировали серьёзные галлюцинации у всех готовых моделей при объяснении финансовых терминов и запросах исторических цен акций. Модель, дообученная на финансовых текстах, галлюцинировала чаще базовой, поскольку частично утратила способность следовать инструкциям (Kang, Liu, NeurIPS 2023 Workshop).
Вариативность и галлюцинации редко проявляются порознь. Первая означает, что модель может ошибиться в любом месте ответа, вторая — что ошибка будет изложена тем же тоном, что и верное утверждение. В сумме получается собеседник, который никогда не говорит «не знаю», а значит, его «знаю» без внешней проверки ничего не стоит.
Ошибка модели, однако, превращается в убыток лишь тогда, когда её пропускает человек. Поэтому следующее звено цепочки — пользователь.
3. Человеческий фактор и когнитивные искажения
Даже при безупречной работе алгоритма итоговое качество инвестиционного решения определяется тем, как человек взаимодействует с системой. Типичная цепочка выглядит так: неполный запрос → угодливый ответ модели → доверие без проверки (automation bias) → финансовый убыток.
Полнота и качество запроса
Вопрос «куда вложить сто тысяч» кажется простым, но содержит десяток скрытых: инвестиционный горизонт, допустимый убыток, валюта расчёта, наличие долгов, обслуживание которых дороже любой доходности, налоговая юрисдикция, соотношение этих средств с остальным имуществом. Профессионал задаёт эти вопросы прежде, чем произнести слово «облигация». Модель отвечает ровно на тот вопрос, который ей задали, и отвечает хорошо — в том смысле, что текст получается складным.
Экономисты Стэнфорда и MIT попросили представительную выборку взрослых американцев самостоятельно сформулировать запрос к ИИ о расходах и инвестициях, а затем смоделировали результат следования полученным советам на протяжении всей жизни. Для большинства советы оказались разумнее их текущего поведения. Однако замена запросов, написанных участниками, на запросы, составленные исследователями, заметно улучшала советы, а различия в качестве запросов между группами с разным уровнем финансовой грамотности к пенсии превращались в разрыв в накопленном капитале на 4–5 % (Choukhmane, de Silva, Lin, Akuzawa, Stanford GSB Working Paper 4325, 2026). Модель в этом разрыве не виновата: она добросовестно ответила на то, о чём её спросили.
Эффект избыточного доверия (automation bias)
• Исследование Университета Хоэнхайма. В эксперименте с реальными денежными последствиями одного знания о том, что совет сгенерирован ИИ, оказывалось достаточно, чтобы участники следовали ему даже вопреки имеющейся у них информации и собственной оценке, причём в ущерб себе и третьим лицам (Klingbeil, Grützner, Schreck, Computers in Human Behavior, 2024).
• Эксперимент Гарвардской школы бизнеса и BCG. На творческих задачах доступ к GPT-4 повысил качество работы 758 консультантов BCG на 40 %. Однако в задаче, где верный ответ требовал заметить нестыковку в данных, консультанты с ИИ оказывались правы на 23 % реже контрольной группы: верное решение нашли 70,6 % участников с доступом к модели и лишь 60 % в группе, которой дополнительно провели инструктаж о её возможностях и ограничениях (Dell’Acqua et al., «Navigating the Jagged Technological Frontier», 2023). Инструктаж, таким образом, сделал результат хуже — редкий случай, когда обучение технике безопасности повышает травматизм.
Речь идёт о специалистах с лучшим профильным образованием. Частному инвестору без такой подготовки рассчитывать на более высокий результат не приходится.
Угодливость модели (sycophancy)
Обучение моделей с подкреплением на основе оценок людей (reinforcement learning from human feedback, RLHF) формирует у них склонность подстраиваться под мнение пользователя: люди чаще высоко оценивают ответы, совпадающие с их взглядами. Исследование Anthropic показало, что пять ведущих моделей меняли верный ответ на неверный, когда пользователь выражал сомнение, и подстраивали суждения под позицию спрашивающего (Sharma et al., ICLR 2024). Вопрос «сейчас ведь отличный момент для покупки технологических акций?» получит подтверждение — не потому, что момент отличный, а потому, что его так назвали.
Исследование Университета Санкт-Галлена в четырёх экспериментах установило, что рекомендации трёх популярных моделей увеличивали риски портфелей частных инвесторов по всем пяти измерениям: географической концентрации, отраслевому перекосу, следованию за трендом (momentum), доле активного управления и совокупным издержкам. Приёмы устранения этих перекосов помогали лишь частично (Scherer, Lehner, PLOS ONE, 2025). Модель воспроизводит ошибки толпы, на текстах которой обучалась, а угодливость обеспечивает пользователю комфортное место в этой толпе.
В совокупности неподготовленный инвестор задаёт неполный вопрос, получает уверенный ответ, не располагает средствами его проверить и слышит в нём отражение собственных ожиданий. На рынке, который систематически наказывает одинаково мыслящих, это рецепт не успеха, а синхронной ошибки. Насколько реальна эта цепочка, лучше всего видно на конкретных случаях.
4. Практические случаи критических ошибок ИИ
Следующие случаи примечательны тем, что ошибки допустили не частные инвесторы, а организации с крупными бюджетами и штатом редакторов. Шансы новичка с чат-ботом заметить подобную ошибку заведомо ниже.
| Организация | Дата | Суть случая | Последствия |
|---|---|---|---|
| Microsoft, презентация Bing с ИИ | Февраль 2023 | При разборе квартального отчёта Gap модель указала операционную маржу 5,9 % вместо 3,9 %, рост продаж вместо прогнозируемого снижения, денежные средства 1,4 млрд долл. вместо 679 млн и запасы 1,9 млрд вместо 3,04 млрд | Ошибки прошли все репетиции и были обнаружены независимым исследователем через неделю после показа (CNBC, Fortune) |
| Технологический сайт CNET | Конец 2022 — январь 2023 | Публикация 77 финансовых статей, написанных ИИ; в статье о сложных процентах доход по вкладу 10 000 долл. под 3 % годовых за год назван равным 10 300 долл. вместо 300 | Исправления к 41 статье из 77, то есть больше чем к половине (The Verge, Gizmodo) |
| Mirror Trading International, предупреждение CFTC | Январь 2024 | «Торговый алгоритм» с гарантированной доходностью 10 % в месяц при входе от 100 долл. в биткойнах и фальшивыми балансами на демонстрационных счетах | Официальное предупреждение регулятора о злоупотреблении темой ИИ (CFTC Customer Advisory, 2024) |
Случай Microsoft — галлюцинация в чистом виде: документ находился перед моделью, задача сводилась к переносу нескольких чисел, и тем не менее числа были выдуманы. Случай CNET показателен жанром: речь шла не о прогнозах, а о справочных текстах о сберегательном счёте, то есть о самом простом виде финансового письма. В случае Mirror Trading ИИ не ошибался — его попросту не было. Однако аудитория, уже поверившая, что алгоритм умнее рынка, не задала единственного необходимого вопроса: если робот гарантированно приносит более 200 % годовых, зачем его владельцу сто долларов частного инвестора?
Во всех трёх случаях проверка либо отсутствовала, либо оставалась формальной. Как выглядит проверка, выполненная всерьёз, и чего она стоит, удобнее показать на собственном опыте.
5. Архитектура аналитического конвейера American Investor
Опыт American Investor по сути представляет собой практическую проверку всех предыдущих выводов: каждый элемент нашего конвейера появился как ответ на один из описанных рисков. Линейка American Investor включает десять аналитических продуктов — от месячного «Макрорежима США» до недельных «Потоков в фонды» и «Настроений рынка», — и у каждого есть собственное задание, собственный расчёт и собственное расписание. Чтобы исключить воздействие описанных рисков, подготовка отчётов строится по строго разделённой схеме, в которой модели доверено значительно меньше, чем принято предполагать. Почти каждый пост контроля в этой схеме появился после конкретной ошибки с данными.
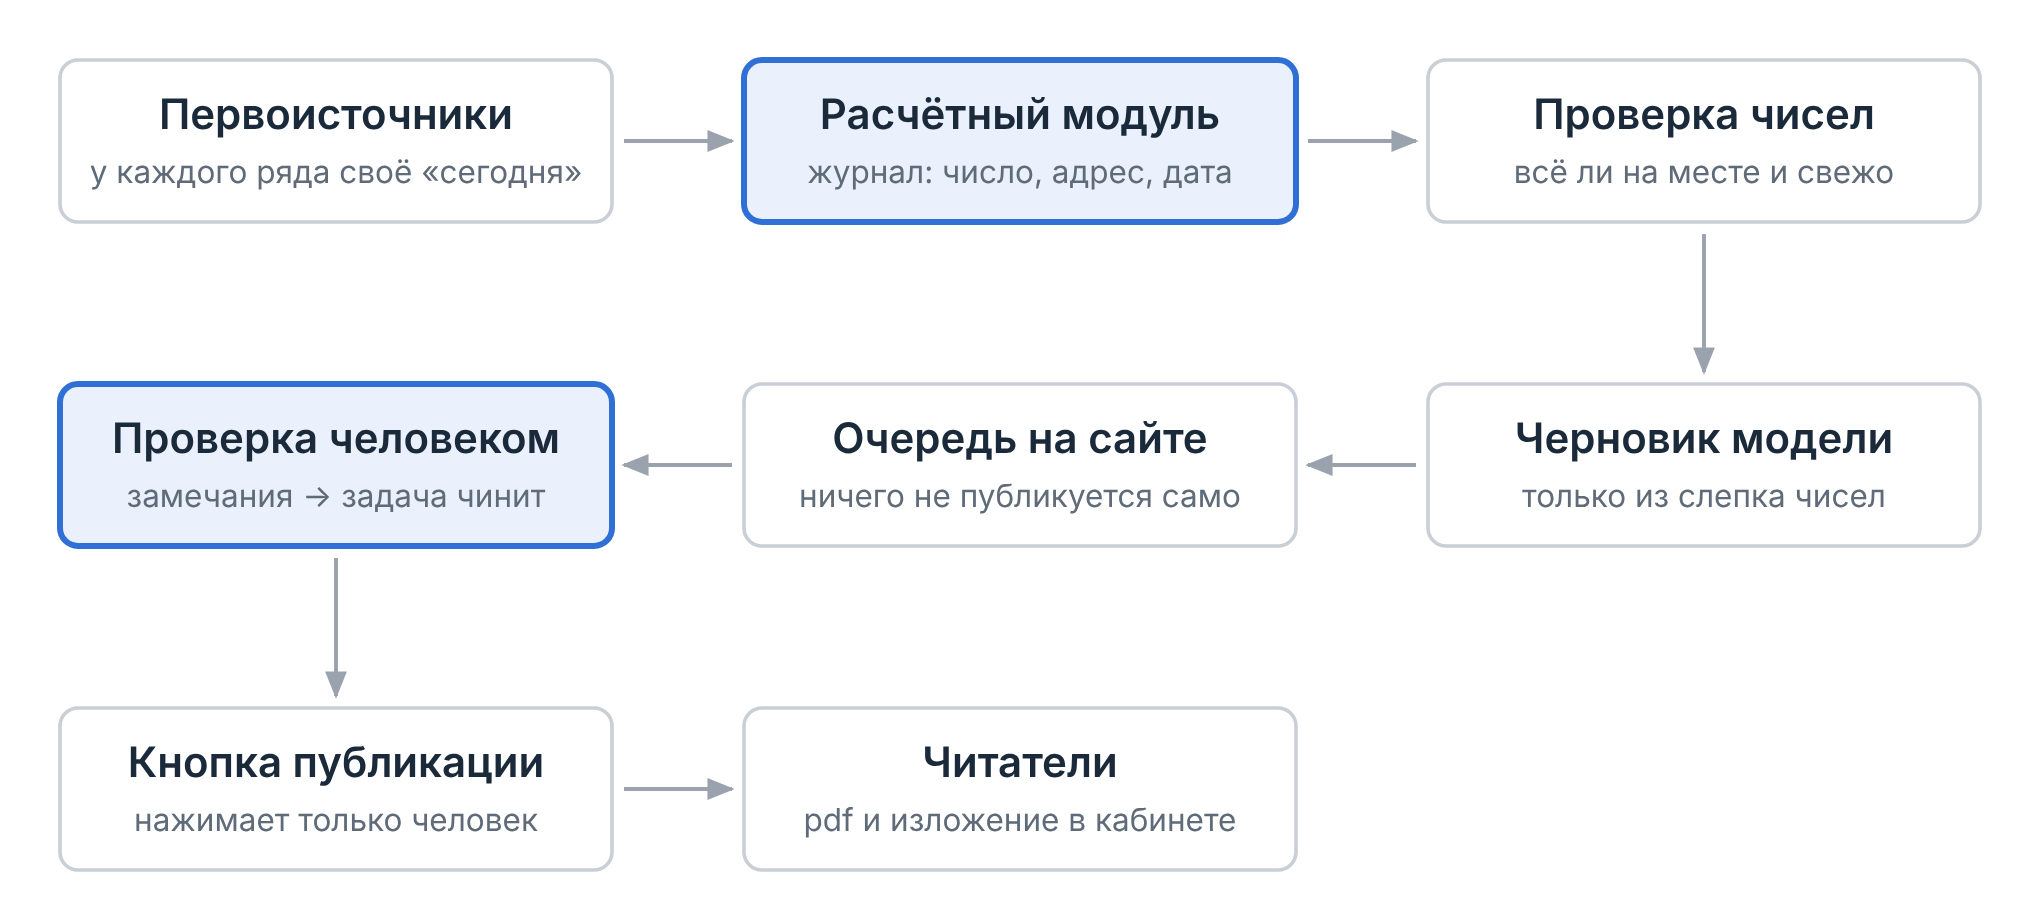
Числа формируются в коде и проходят проверку до того, как модель напишет первое слово; публикацию запускает только человек.
Посты контроля и правила проверки
1. Изоляция вычислений. Языковая модель полностью лишена функций расчёта и сбора данных. Отдельный расчётный модуль получает данные из первоисточников, записывает каждое значение в журнал с адресом и датой получения и передаёт модели готовый слепок чисел. Правило появилось после выпуска, ушедшего на сайт вообще без исходных чисел: модель восстановила их по памяти, и выглядело это безупречно.
2. Контроль полноты показателей. Автоматическая проверка подтверждает наличие всех обязательных показателей продукта — у «Макрорежима США» их 58 — и свежесть рядов. Любой пробел в данных объявляется явно, с перечнем опрошенных источников. Ограничение этой проверки признано с самого начала: правдоподобное, но неверное значение она не обнаруживает. Против него работает только журнал, где у каждого числа указаны источник и время получения.
3. Фильтрация аномалий и проверка источников. Правдоподобные неверные значения поступают, как правило, не от модели, а от источников:
– Вторичные источники. Один из агрегаторов показал соотношение опционов пут и колл (put/call ratio) 1,11 на дату, когда первичный файл биржи CBOE давал 0,63 — разница между «рынок в панике» и «рынок спокоен».
– Ошибки разбора. Разбор состава индекса S&P 500 со страницы Wikipedia однажды вернул четыре бумаги вместо 503, поскольку первая таблица на странице оказалась навигационной. Расчёт широты рынка по четырём бумагам выглядит ничуть не хуже расчёта по пятистам — до первой сверки.
– Разовые переоценки. Рост прибыли компаний индекса S&P 500 за второй квартал 2026 года составил 47,4 %, однако эта величина оказалась следствием разовых переоценок у двух компаний; без них рост составил 28,8 %.
– Накопительные итоги. Часть фактов в отчётности компаний приводится нарастающим итогом с начала года, и квартальное значение приходится вычислять вычитанием.
– Прогнозы менеджмента. Прогноз сверяется с текстом пресс-релиза компании на дату объявления, а не с последующими пересказами.
– Ошибки подающих. Регулятор не исправляет опечатки в отчётах о сделках инсайдеров; строки стоимостью свыше двух миллиардов долларов и с нулевой ценой исключаются вручную.
– Неполная загрузка. Однажды загрузка по списку ссылок молча пропустила файл — тринадцать адресов, двенадцать файлов. С тех пор число загруженного всегда сверяется с числом ссылок.
4. Учёт временных лагов (temporal alignment). Ряды данных обновляются с разным запозданием: валюты, широкий индекс доллара и нефть в базе FRED отстают на три-пять торговых дней; секторные индексы на бесплатном канале — на две-три недели, поэтому текущая картина по секторам строится по биржевым фондам; отчёт CFTC о позициях выходит с трёхдневным лагом; отношение кредита к ВВП от BIS — с опозданием около полугода; опрос частных инвесторов AAII публикуется в четверг и несколько дней не индексируется поиском; ряд розничных средств в фондах денежного рынка опаздывает на месяц и у минимумов 2018–2022 годов показывал норму, из-за чего был исключён из одного из продуктов. Без учёта этих лагов отчёт сравнивает вчерашнюю цену с позициями за прошлую неделю и кредитом за прошлую зиму. Отсюда три правила: дата среза данных отделена от даты выпуска, и свежесть проверяется от среза; изменение «за четыре недели» считается по календарю, а не отсчётом четырёх точек назад, поскольку у недельного ряда с пропуском это разные величины; длительность любого состояния определяется по ряду, а не по графику — после того как модель написала «четвёртый месяц» по виду тепловой карты при фактических трёх неделях.
5. Длина истории. Запрос «вся история» у одного из каналов возвращает квартальные точки вместо дневных, а окно в шестнадцать лет вместо полной истории с 1927 года вдвое сокращает число исторических эпизодов и соответственно искажает оценку того, насколько редка текущая ситуация.
6. Человек в контуре (human-in-the-loop). Модель не имеет доступа к публикации. Готовый выпуск поступает в очередь на сайте, проходит экспертную проверку, правится по замечаниям и отправляется читателям только по решению редактора. Модель трижды пыталась выложить выпуск после правок без команды и трижды вполне искренне соглашалась, что так делать не следовало.
7. Контроль расписания. Каждый продукт запускается собственной ночной задачей, а вечерняя проверка сверяет по единому календарю, поступил ли ожидаемый черновик, и при его отсутствии отправляет уведомление. Молчаливый сбой оказался опаснее явного.
Сроки и выводы
Построение конвейера заняло три года. American Investor работает с 2023 года, и всё это время схема перестраивалась: каждая новая возможность модели открывала новый способ ошибиться, и под него требовался новый пост контроля. Уроки обошлись дорого, но формулируются коротко. Число берётся только из первоисточника и имеет дату. У каждого ряда своё «сегодня». Правка задания не даёт права изменять готовый выпуск. И главное: проблема не в модели. Почти каждый неудачный выпуск был следствием того, что кто-то — человек или машина — принял число, не выяснив его происхождения.
У частного инвестора нет ни такого конвейера, ни трёх лет на его построение. Однако принципы, на которых он основан, переносятся и на индивидуальную практику.
Рекомендации для частных инвесторов
Отказываться от чат-ботов нет необходимости: они полезны там, где требуется объяснить термин, изложить длинный документ или подготовить список вопросов к брокеру. Опасны они в одной роли — советчика, чьё слово не проверяется. Каждое из правил ниже закрывает одно из звеньев описанной цепочки: первые два — ошибки модели, третье и четвёртое — слабости запроса и угодливость, пятое — злоупотребление самой темой ИИ.
1. Проверка данных в первоисточниках. Любые числа, названные моделью, подлежат сверке с оригинальными документами: отчётностью компаний, данными регуляторов, страницей фонда. Наличие ссылки ничего не гарантирует — модель Microsoft в феврале 2023 года тоже «опиралась» на отчёт Gap.
2. Проверка вариативности. Один и тот же вопрос следует задавать в разных сессиях и в разных формулировках. Существенное расхождение ответов означает, что ни один из них не заслуживает вложения денег.
3. Отказ от наводящих вопросов. Запрос формулируется нейтрально, без демонстрации собственной позиции: вопрос «какие доводы против покупки сейчас» полезнее вопроса «ведь сейчас выгодно покупать?». Угодливость — свойство обучения модели, и нейтрализовать её можно только формулировкой.
4. Структурированный анализ вместо рекомендации. Следует запрашивать базовый сценарий, ключевые допущения, риски, условия, при которых план перестаёт работать, и сведения, которых модели не хватает для ответа. Похожий подход предлагает Эндрю Ло из MIT, отмечая при этом, что фидуциарной ответственности у моделей нет и цену ошибки несёт пользователь (Lo, Ross, Harvard Data Science Review, 2024).
5. Критическое отношение к обещаниям доходности. Заявления об «алгоритмах на базе ИИ» с гарантированным доходом следует расценивать как признак высокой вероятности мошенничества.
Заключение
Цепочка замыкается там, где началась, — на рынке. Он остаётся системой с миллионами участников и обратными связями, в которой одинаковые решения одинаковых советчиков рано или поздно сходятся в одной точке одновременно. Когда это впервые произойдёт с массовыми пользователями чат-ботов, предсказать невозможно. Известно другое: в 2018 году это произошло с продавцами волатильности, и последствия хорошо видны в отчётности их счетов.